

Renyuan LIU(刘稔远)
你好,很高兴在这里认识你!
我是香港中文大学(深圳)的人工智能研究型硕士生(MPhil),导师为李明教授。
我每天高强度使用 AI 编程工具,月消耗 百亿量级 Token。
目前,我的工作聚焦 AI Agent 与 AI 基础设施(AI Infra)。
研究兴趣
AI Agents:智能体工具调用、记忆系统;
AI Infrastructure:国产算力适配、大模型架构、算子优化。
精选 AI 项目
百工具电商规划系统
负责覆盖 100 个工具、8 大业务域的电商导购 Agent 研发,在 9,000 条静态测试请求上实现 92.6% 的端到端准确率。


展开项目详情
项目背景:作为核心研发,负责 100 工具、8 大业务域电商导购 Agent 研发,解决全量工具开销、同类工具混淆、多需求顺序错误与跨轮历史污染。
- 意图分流(分类准确率 100.0%):构建 4.8 万条电商/闲聊数据,LoRA 微调 Qwen3-0.6B,9,000 条隔离测试准确率 84.8%→100.0%;较 Qwen3-1.7B,推理中位延迟降低 34.3%、吞吐提升 52.0%。
- 高效工具检索(Top-10 工具全召回率 97.4%):构建 7 万正对与 9.6 万类型化负例,采用多负例对比学习微调 bge-large,并以 1:7 正负难例组训练 bge-reranker-v2-m3;实现 BM25/向量双路召回、两级 RRF 融合与 Cross-Encoder 精排,采用“召回 40→精排 20→规划 10”的分层筛选,Top-10 全召回率 47.6%→97.4%;相较“精排 30→规划 20”方案,规划模型输入 Token/重排中位延迟降低 36.8%/33.7%。
- 多步工具规划(端到端准确率 92.6%):构建 7.8 万条多风格工具调用轨迹,基于 MS-SWIFT 使用 LoRA 微调 Qwen3-8B,在固定 Top-10 候选中输出有序工具链;基于父模型真实错误构建 4,000 组偏好对,通过偏好优化训练及低学习率 DPO 收敛,规划模型工具链完全匹配率 85.7%→88.9%;在 9,000 条静态测试上,端到端准确率达 92.6%。
- 多轮 Agent 框架(上下文依赖请求准确率 92.8%):设计模型外上下文编排器,以规则状态机调度近期状态、规则摘要与会话内 BM25,将必要历史压缩并补全为可独立规划的当前请求,再接入原规划模型,通过请求边界与整轮恢复抑制历史污染;基于近 2,000 段 2–7 轮自然短会话完成 12 阶段消融,独立测试整体准确率较直接拼接基线 50.5%→94.6%,上下文依赖/无关请求准确率达 92.8%/97.4%,版本校验缓存使规划模型调用减少 60.3%。
核心成果:9,000 条隔离测试意图准确率 100.0%;Top-10 工具全召回率 97.4%(基线 47.6%);端到端准确率 92.6%;上下文依赖请求准确率 92.8%,规划模型调用减少 60.3%。
国产算力适配和昇腾算子agent
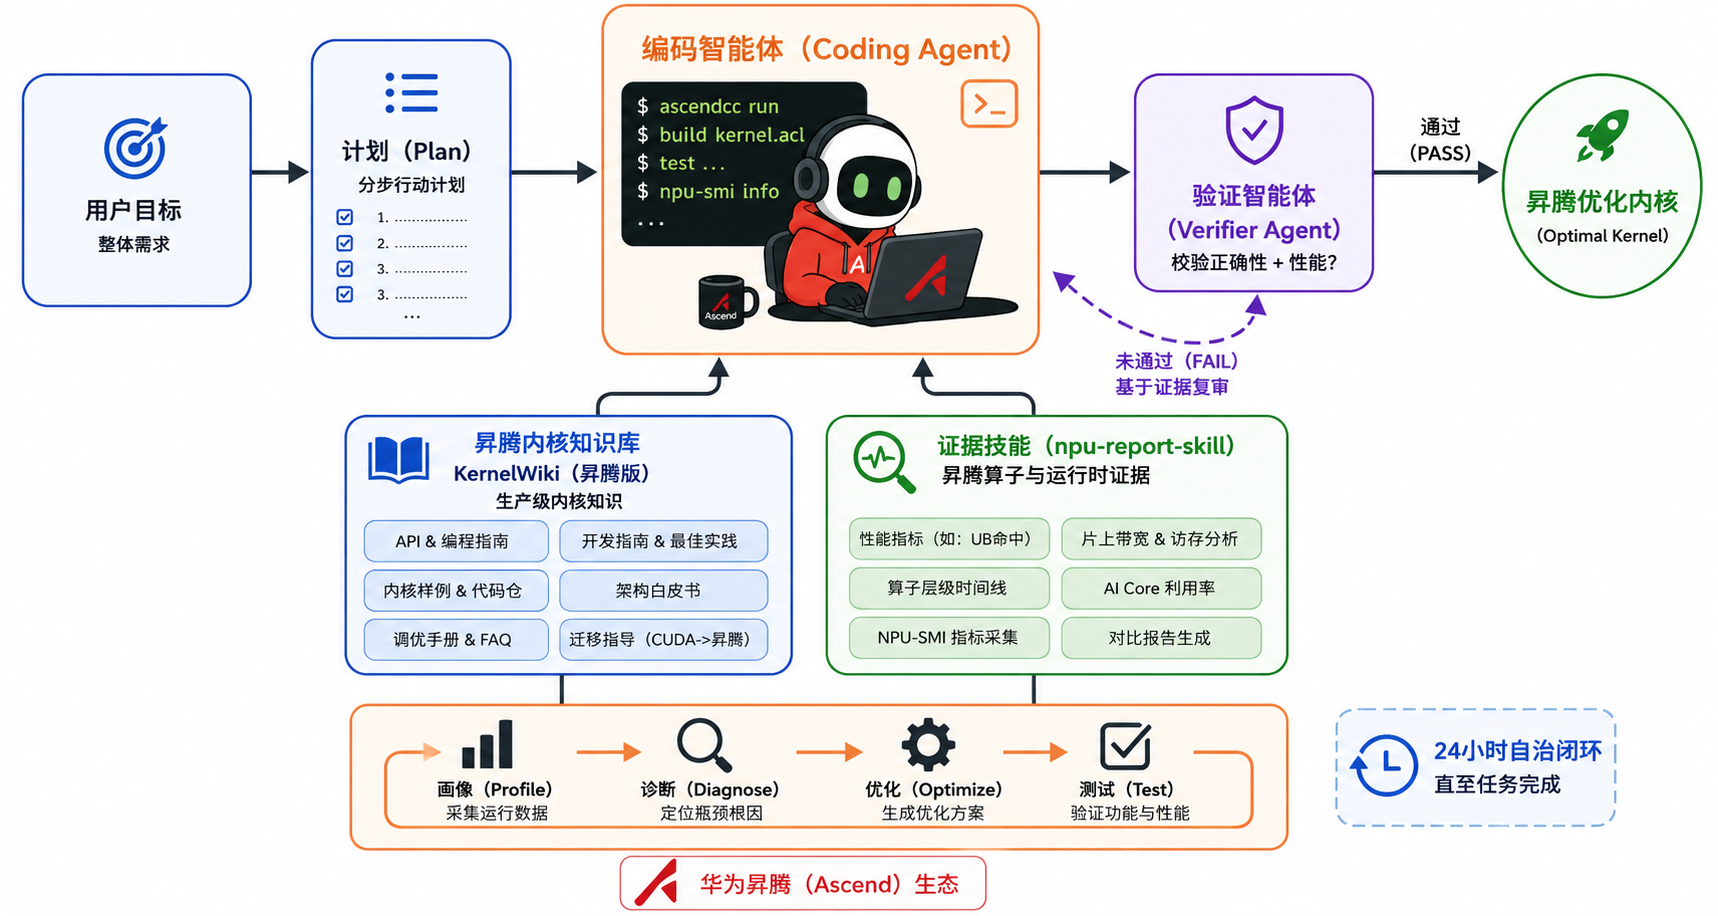
负责 DeepSeek-V4 部署测评与昇腾算子优化,在目标配置下将融合反向算子耗时降低 20.9%。
展开项目详情
项目背景:作为核心研发,参与深圳河套学院联合华为、智子芯元开展的 DeepSeek-V4-Pro 国产算力全参数后训练。围绕 DeepSeek-V4 在国产算力上的推理与后训练落地,负责昇腾 910C 部署测评、算子优化 Agent 研发及融合反向算子优化。
- 910C 推理适配与测评(DeepSeek V4 Flash/Pro):参与在昇腾 910C 集群部署与测评 DeepSeek V4 Flash/Pro,基于 ShareGPT 等数据对比 vLLM Ascend 与 SGLang 的 Prefill/Decode 性能,为推理框架选型与部署配置提供依据。
- 算子优化 Agent(昇腾迁移与开源):针对昇腾算子依赖人工分析与反复试错的问题,基于 MIT Kernel Design Agents 重构适配 910B/910C 的算子知识库、优化规则与性能诊断工具,打通检索→生成→编译→精度/性能验证→保留/回退闭环,开源 Kernel-Agent-Ascend。
- 融合反向算子优化(耗时降低 20.9%):基于 msprof 定位 AIV 侧标量地址计算、稀疏访存、同步等待与负载不均;通过地址计算化简、低命中搬运分支裁剪、冗余同步删除、分块/片上缓存优化及向量任务重分配,同时修复缓存扩容引发的尾块越界,算子耗时 22.603→17.88 ms(1.26×),四路输出余弦相似度均为 1.0。
核心成果:目标配置(BSND/BF16,B=1、S=4096、K=1024)下,融合反向算子耗时 22.603→17.88 ms,降低 20.9%(1.26×);四路输出余弦相似度均为 1.0,最大相对误差 8.39e-4。
经历
字节跳动,中国深圳
2026 年 9 月 – 至今
实习生
火山引擎(豆包/火山方舟)
工作方向:企业级 AI 智能体(ToB Agent)香港中文大学(深圳),中国深圳
2026 年 9 月 – 2028 年 6 月(预计)
人工智能研究型硕士(MPhil)
永平书院
导师:李明教授
研究方向:大语言模型 / 智能体香港大学,中国香港
2026 年 7 月
暑期学校学员
项目主题:人工智能与机器人香港中文大学(深圳),中国深圳
2026 年 7 月 – 2026 年 8 月
研究助理(RA)
导师:胡君杰教授(人工智能学院)
实验室:Embodied AI & Robotics Lab(EAR Lab)
研究方向:具身智能深圳市大数据研究院(SRIBD),中国深圳
2026 年 3 月 – 2026 年 6 月
算法实习生
导师:王阿康博士(深圳市大数据研究院、深圳河套学院、香港中文大学(深圳)数据科学学院)
工作方向:AI Infrastructure英国约克大学,英国约克(线下)
2025 年 6 月 – 2025 年 9 月
研究助理(RA)
导师:刘鹏程教授
实验室:计算自主学习系统实验室,实时与分布式系统研究组,计算机科学系
研究方向:运动规划
[证明材料]
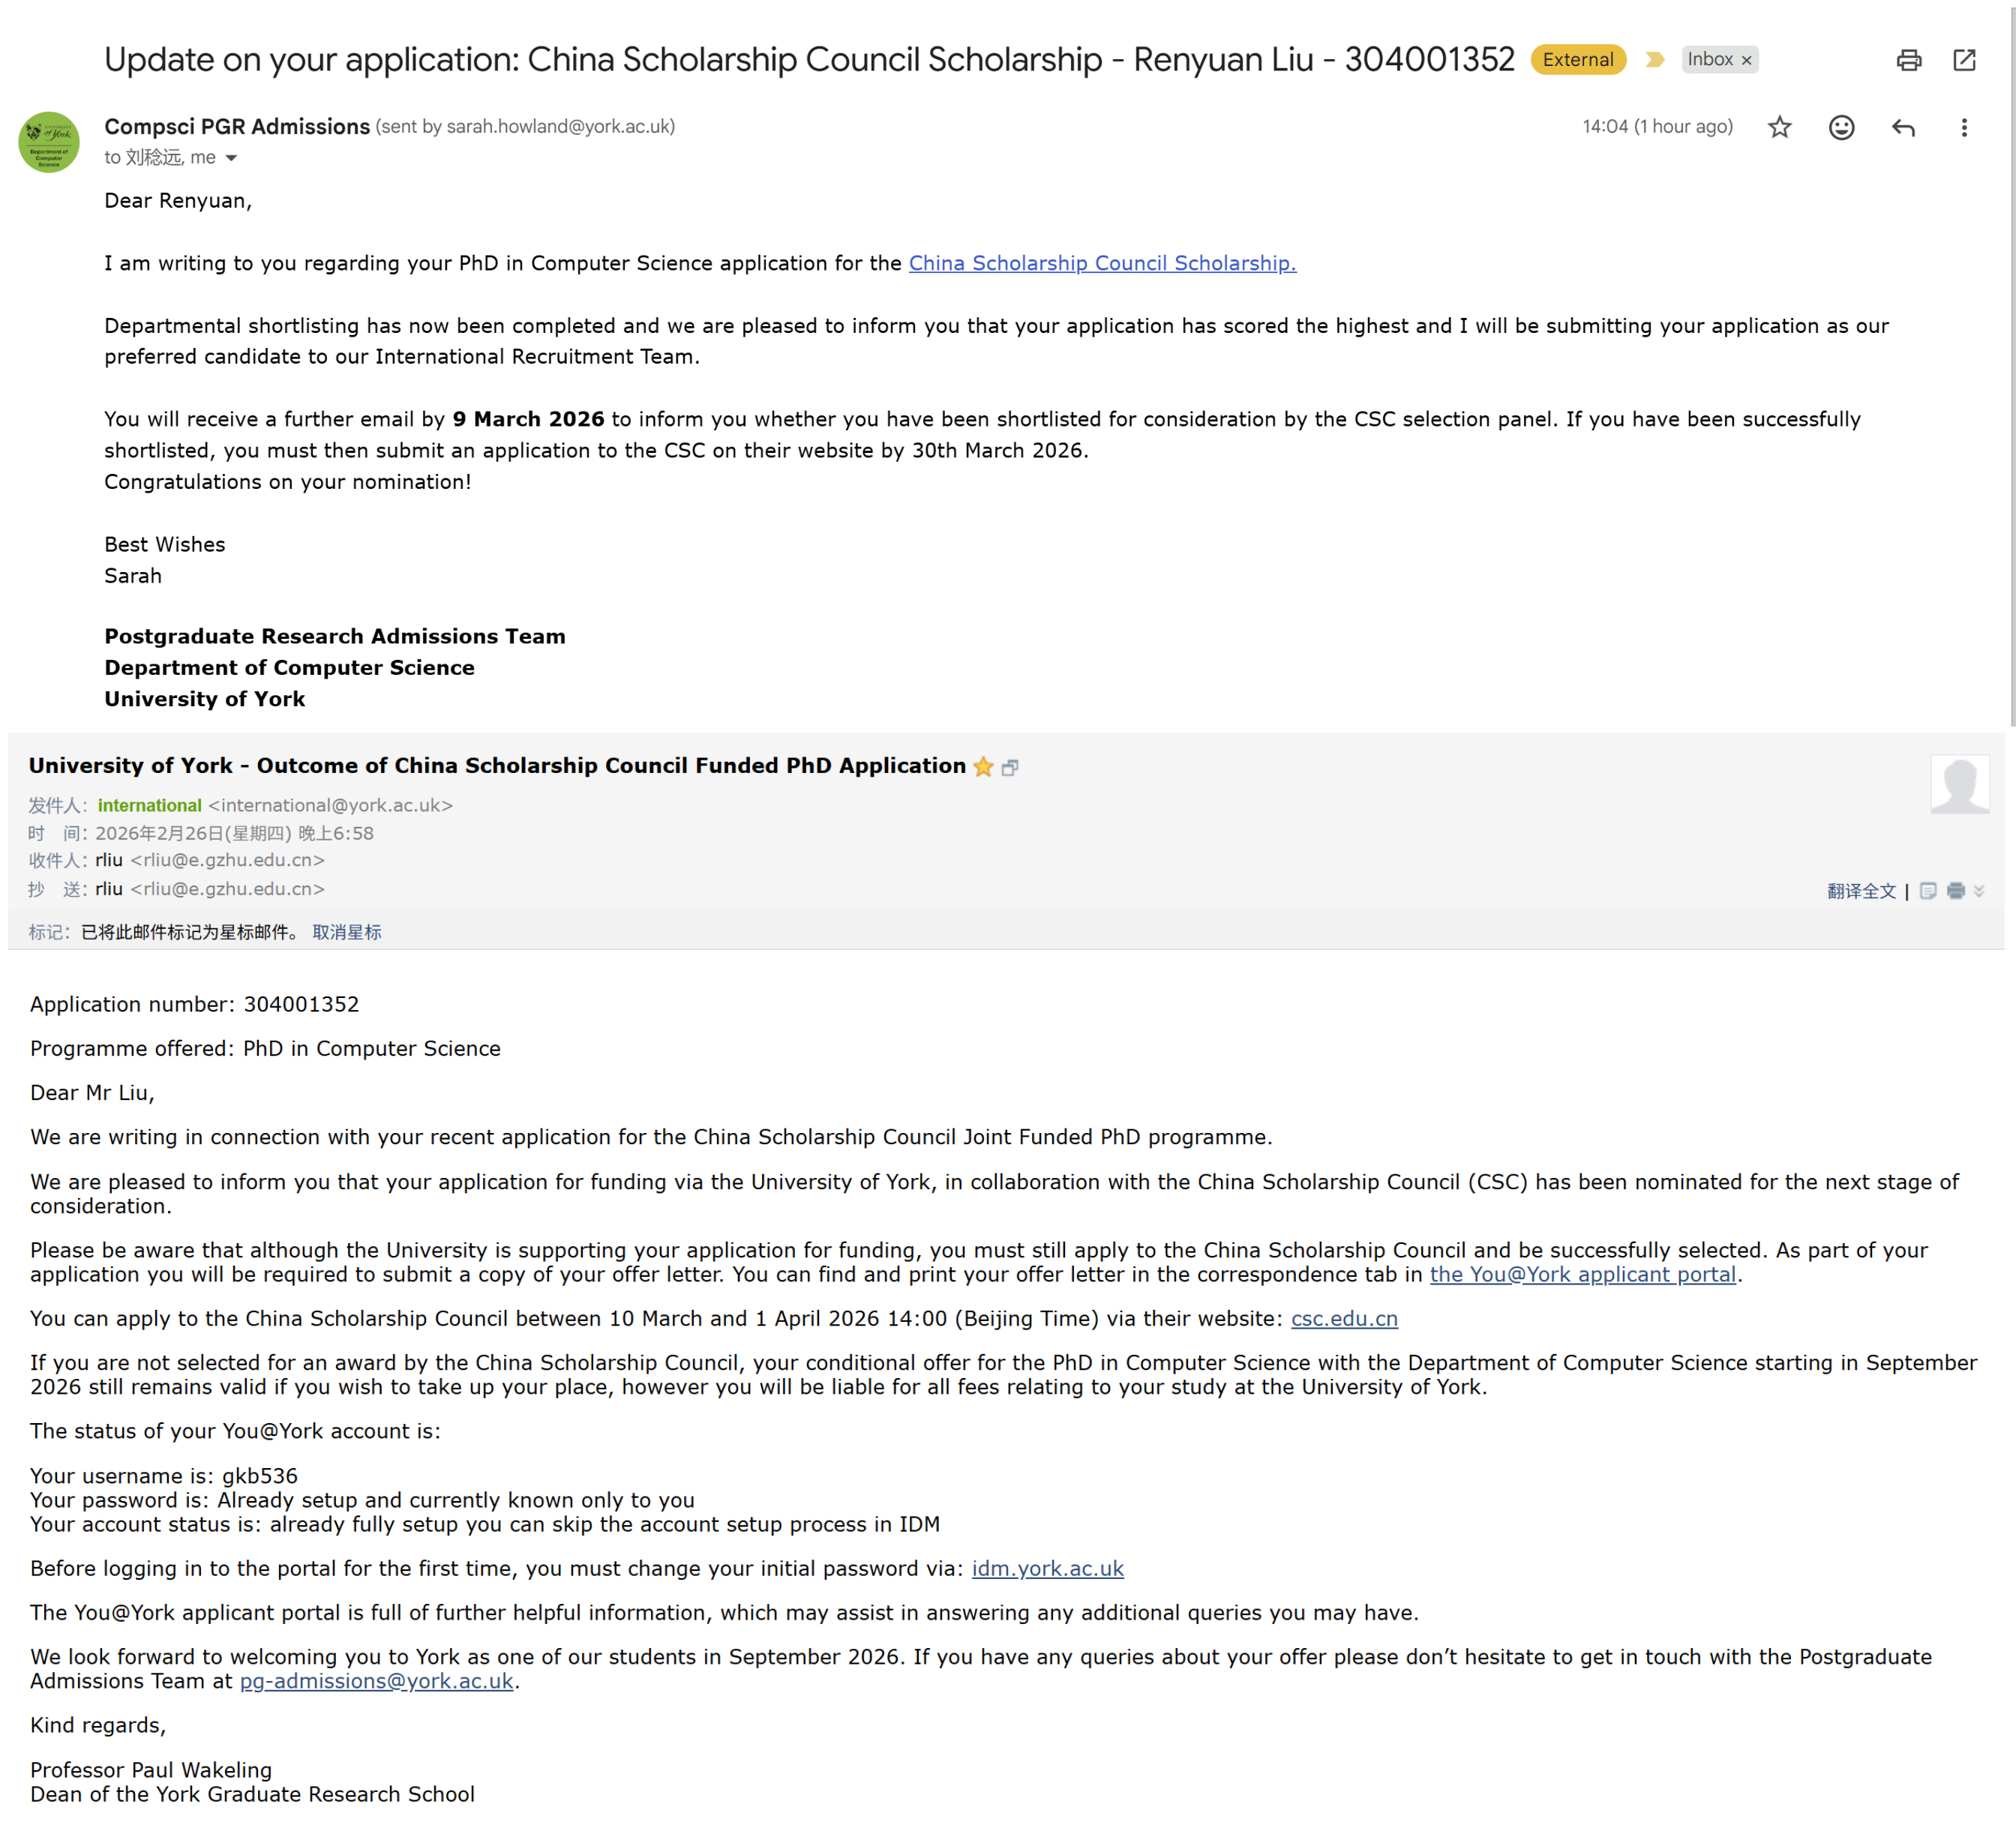
获得直博录取和CSC 全奖提名。澳门大学,中国澳门
2023 年 11 月
跨学科项目
GPA:97.50/100.00;荣誉:获胜团队杰出表现嘉奖信
[证明材料]
论文
在审稿件
[稿件双盲评审中。] 投稿至 IEEE Robotics and Automation Letters(RA-L),研究方向为具身智能与语义导航。
R. Liu、H. Zhou、C. Fang、Q. Fu,How Fly Neural Perception Mechanisms Enhance Visuomotor Control of Micro Robots。arXiv 预印本,arXiv:2509.13827,2025。
M. Wang*、R. Liu*、Q. Fu,[稿件双盲评审中。] 投稿至 IEEE Transactions on Cognitive and Developmental Systems(JCR Q1,IF = 4.9)。
已发表论文
R. Liu and Q. Fu, Attention-Driven LPLC2 Neural Ensemble Model for Multi-Target Looming Detection and Localization. 2025 International Joint Conference on Neural Networks(IJCNN),pp. 1–8, 2025(CCF-C,录用率约 38%)。
G. Gao*, R. Liu, M. Wang and Q. Fu*, A Computationally Efficient Neuronal Model for Collision Detection With Contrast Polarity-Specific Feed-Forward Inhibition. Biomimetics, vol. 9, no. 11, Art. 650, 2024(JCR Q1,IF = 3.9)。
C. Fang*, H. Zhou, R. Liu, and Q. Fu*, A neuromorphic binocular framework fusing directional and depth motion cues towards precise collision prediction. Neurocomputing, vol. 657, Art. 131660, 2025(JCR Q1,IF = 6.5)。
H. Zhou, C. Fang, R. Liu, J. Peng, and Q. Fu, A Bio-Plausible Neural Network Integrating Motion and Disparity Pathways for Looming Perception. 《电子学报》,第 53 卷第 8 期,pp. 2899–2914, 2025(CCF 中文 A 类)。
J. Huang*, Z. Qin, M. Wang, R. Liu, and Q. Fu*, A Biomimetic Collision Detection Visual Neural Model Coordinating Self-and-Lateral Inhibitions. Biomimetic and Biohybrid Systems(Living Machines 2025),LNAI, vol. 15582, pp. 334–346, 2026(口头报告)。 DOI
* 表示共同第一作者。
本科阶段研究背景
本科期间,我有幸在机器生命与智能研究中心接受傅沁冰教授指导,并在英国约克大学计算机科学系接受刘鹏程教授指导。
我的本科研究主要聚焦类脑神经网络与机器视觉:通过建模昆虫视觉回路实现鲁棒的实时运动感知,并将这些机制转化为机器人碰撞检测系统。我喜欢亲手完成编码、调试、性能分析和端到端系统实现。实验平台包括配备双目相机的 TurtleBot 与微型地面机器人 Colias。
面向神经具身微型机器人 Colias 的部分代码:
- 果蝇视觉运动启发的 Attention-LPLC2 模型(独立完成,约 2,000 行 C 代码);
- 多注意力 LPLC2(mLPLC2)神经网络模型(独立完成,约 3,000 行 C/C++ 代码);
- 蝗虫视觉启发的 Optimized-LGMD 模型(独立完成,约 1,000 行 C 代码)。
荣誉与奖励
本科毕业设计创新奖(全校第 3 名)
2026 年 6 月省级一等奖(前 3%),中国大学生计算机设计大赛
2025 年 5 月 [证明材料]国际二等奖(Honorable Mention),美国大学生数学建模竞赛(MCM)
2025 年 1 月 [证明材料]国家一等奖(前 5%),亚太地区大学生数学建模竞赛
2024 年 11 月 [证明材料]省级一等奖、创新银奖(1,167 支队伍中第 2 名),“大湾区杯”粤港澳金融数学建模竞赛
2024 年 11 月 [证明材料]二等奖学金(前 8%)
2025 年 12 月 [证明材料]三等奖学金(前 12%)
2024 年 11 月 [证明材料]一等奖学金(前 5%)
2023 年 12 月 [证明材料]获胜团队杰出表现嘉奖信,澳门大学跨学科项目——新媒体、科技创新、艺术与数据挖掘
2023 年 11 月 [证明材料]省级重点大学生创新创业训练计划项目:基于光流与学习优化的仿生 LGMD 碰撞检测模型(S202411078014)
技术能力
喜欢攀岩、烹饪、篮球和主机游戏
学习资料与启发文章
基础必修 (27)
- CS336:从零构建大语言模型
- CS336 学习笔记
- 动手学深度学习 Dive into Deep Learning
- 图解 Transformer
- 图解注意力机制与 Seq2Seq
- The Annotated Transformer
- DDA5001 机器学习课程笔记
- 图解量化 A Visual Guide to Quantization
- MoE 综述:混合专家与大模型扩展
- Qwen 技术报告解读
- LeetCode 热题 100
- ARIS-in-AI-Offer:AI Offer 教程清单
- Kimi K3:Open Frontier Intelligence
- Linux Commands Cheat Sheet
- ICLR 2027 Conference
- ICLR 2027 投稿指南
- ELF:嵌入式语言流
- Kimi K3 技术报告详解
- T5:Text-to-Text Transformer 模型详解
- 基础算法精讲
- LeetCode 探险:数据结构与算法
- 如何科学刷题
- 算法题单:滑动窗口与双指针
- Stable-DiffCoder:开源代码扩散语言模型
- Stable-DiffCoder:代码扩散语言模型论文
- LiveBench:大语言模型评测
- CodeTop:算法面试题目整理
基础设施 (51)
- LeetGPU:GPU 编程挑战
- How to Scale Your Model:如何扩展你的模型
- CUDA C++ 编程指南
- vLLM 中文站
- MiniMind:从零理解 LLM 训练
- KernelBench:LLM 能写 GPU Kernel 吗
- 矩阵乘法:从手搓到 CUTLASS 实现
- 从 305GB 到 7.4GB:KVCache 架构演进全景
- GPU Glossary:GPU 术语表
- How to Scale Your Model:并行计算与分片
- How to Scale Your Model:Roofline 模型
- CUDA C++ 最佳实践指南
- Modern GPU Programming for MLSys:GPU 执行模型
- Prefix Caching 详解
- vLLM 推理全流程图解
- vLLM Ascend 官方文档
- MinivLLM:极简 vLLM 实现
- 昇腾开源文档中心
- CUDA-Agent:高性能 CUDA Kernel 生成强化学习
- CANN-Bench:CANN 算子任务评测
- DFlash:Block Diffusion for Flash Speculative Decoding
- KernelHive AI Systems Daily
- DeepSeek-V4-Pro:国产算力集群全参数后训练
- ConvRot:扩散 Transformer 的即插即用 4-bit 量化
- CUDA Kernel:如何设置 grid_size 与 block_size
- Kubernetes 一小时入门
- How to Scale Your Model:理解 GPU
- 深入理解 AI Infra:量化分析与系统设计
- CUDA 编程模型
- GPU Glossary:CUDA 设备架构
- CUDA 教学视频合集
- PTX ISA 9.2 指令集参考
- vLLM 调度机制
- LuoSS:镜像存储指南
- SGLang:Ascend NPU 与 DeepSeek-V4-Flash 支持实现
- LLM Torch Profiler 性能分析技能
- ops-fft:基于 CANN 的 FFT 算子库
- DeepSeek-V4-Flash:昇腾部署入门
- DeepSeek-V4-Flash:昇腾 910B 单机部署
- GPUStack:Qwen3-30B-A3B 昇腾 910B 性能参考
- SOL-ExecBench:Agent 时代的算子开发实践
- Agent 自动优化 CUDA Kernel 实践
- AI-Infra-Auto-Driven-SKILLS:基础设施技能库
- KDA-Pilot:Agent 驱动的 Kernel 优化
- InfraTech:Kimi K3 模型架构
- InfraTech:DeepSeek V4 模型架构
- InfraTech:AI Infra 知识与代码练习
- 图解 MLA 计算流与吸收矩阵
- vLLM 显存管理详解
- 大模型推理并行策略:DP / TP / PP / SP / EP
- 大模型架构 3D 可视化
智能体 (36)
- Learn Harness Engineering
- 18 种 RAG 技术实测对比
- TypeScript 基础语法
- Hello-Agents:动手学智能体
- The 2025 AI Agent Index
- Awesome AI Model Routing
- 大模型 RAG 基础:信息检索、文本向量化及 BGE-M3 实践
- Coordinator 编排:Claude Code 并行工作线程解析
- 多智能体协调器:Claude Code 如何编排并行工作线程
- Agent Skills:技能生态入口
- opencode:开源 AI 编程 Agent
- Agent Foundations 面试 Cheat Sheet
- Terminal-Bench:终端智能体能力评测
- CoEvoSkills:共进化验证的自进化 Agent Skills
- Elasticsearch:从入门到进阶
- MTEB:文本嵌入模型评测榜单
- STALE:LLM Agent 记忆何时失效
- Evo-Memory:智能体测试时学习与自进化记忆
- AI-Research-SKILLs:AI 研究与工程技能库
- MemEvolve:智能体记忆系统的元进化
- Agent Pulse:AI 行业关键变化与证据
- RLMOpt:递归语言模型驱动的自适应 Prompt 优化
- 华为云 AI 办公实践中心
- AgentGuide:智能体研究前沿
- ToolGym:工具调用评测与数据集
- Continual Learning Bench:真实有状态环境中的持续学习评测
- Codex:MCP 接入指南
- Agent-World:真实环境合成与通用智能体
- OpenShell:自主智能体运行时
- Claude Code 源码精读
- 深入理解 AI Agent:设计原理与工程实践
- OpenViking:智能体上下文与记忆
- OpenViking:检索机制
- ReasoningBank:智能体记忆与测试时扩展
- ASI-Bench:自主科研能力评测
- QUIT:人在回路的 AI 科研自动化平台
具身智能 (21)
- Danfei Xu 访谈:人类数据、行为克隆、机器人 GPT-3
- UC Berkeley Ember Seminar:SONIC + BFM zero
- Robotic Manipulation
- MoveIt Tutorials
- MuJoCo:Advanced Physics Simulation
- LIBERO:Lifelong Learning Algorithms
- LEGION:机器人终身强化学习
- Open X-Embodiment:机器人学习数据集与 RT-X 模型
- Awesome World Models for Embodied AI
- X-VLA:跨具身视觉-语言-动作模型
- Data Pyramid & Data Flywheel for Robotic Foundation Models
- Whole-Body Coordination for Legged Manipulators
- TransCG:透明物体深度补全和抓取数据集
- Depth Anything V2:单目深度估计
- Marigold:Diffusion-Based Monocular Depth Estimation
- VLA-Handbook:视觉-语言-动作学习与面试手册
- ASGrasp:透明物体重建与 6-DoF 抓取
- Reflective Planning:VLM 长程机器人操作规划
- MiDaS v3.1:单目相对深度估计
- Depth Anything:单目深度估计
- VGGT:前馈 Transformer 与 3D 几何感知
大模型后训练 (22)
- 强化学习 · 大模型后训练版
- 强化学习入门:从马尔可夫到 PPO / DPPO
- 用 LLaMA 训练你自己的大语言模型
- 从零「手搓」一个大模型
- 大模型 LLM 面经(实时更新)
- Modern LLM Notebook
- Tianshou 天授:强化学习库
- 为什么 base model 还不是 assistant
- 后训练介绍
- DAPO:大规模开源 LLM 强化学习系统
- PPO:有了奖励模型,为什么还需要价值模型
- On-Policy Distillation:Policy Gradient 视角
- On-Policy Distillation:2026 上半年综述
- OPD-Evolver:基于在策略蒸馏的智能体进化
- Off-Policy + On-Policy 两段式蒸馏
- REOPOLD:将 On-Policy Distillation 作为 RL 调优
- On-Policy Distillation:三万字综述
- Sentence Transformers:损失函数参考
- PRISM:中期训练的知识保留与交互
- ARPO:Agentic Reinforced Policy Optimization
- Agent Lightning v1.0:Harnessed Agentic RL
- Agentic ESOpt:低 GPU 需求的长程智能体微调
推荐算法 (11)
访客地图
欢迎计算机科学各方向的交流与合作。访问 TEAM NEXUS